


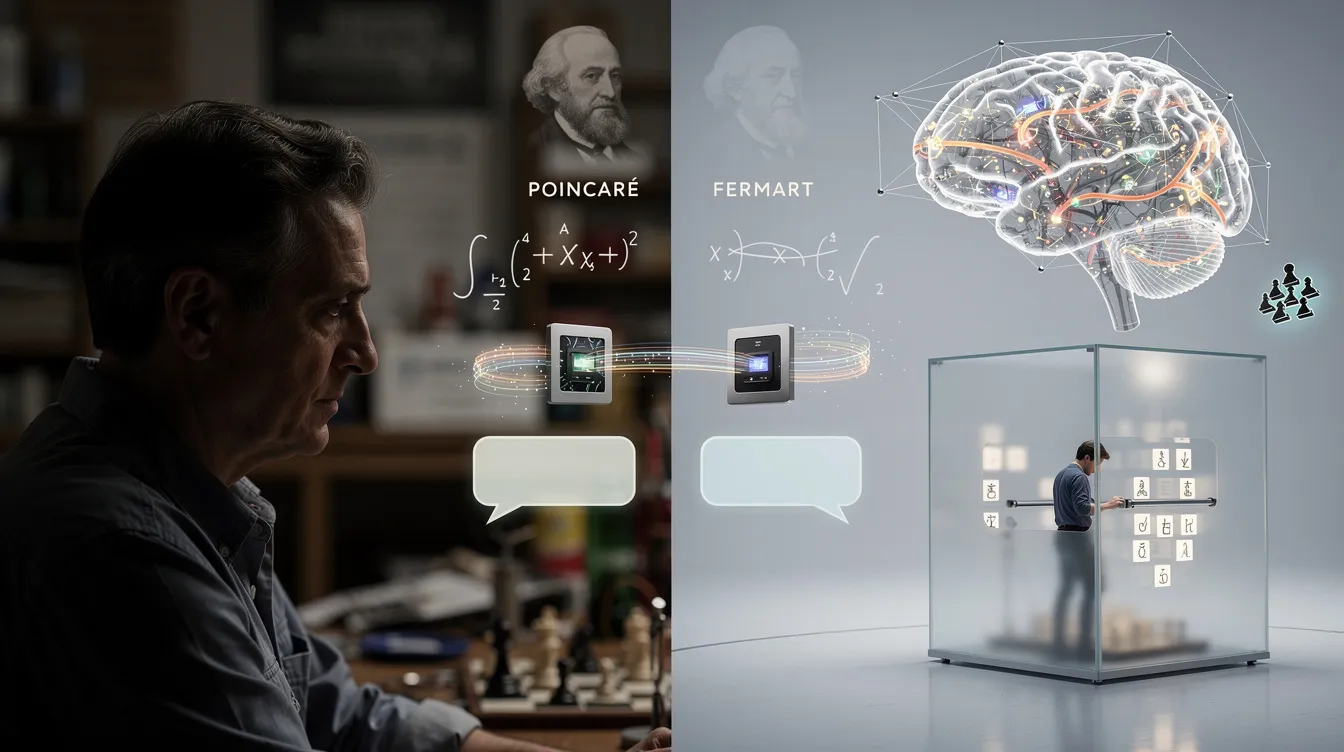
Останнім часом стрічка новин про штучний інтелект нагадує змагання з рекордів. Сьогодні модель довела складну математичну теорему, завтра — розв'язала задачу, над якою вчені билися десятиліттями, післязавтра — навчилася чогось нового у сфері, де раніше поступалася людині. Постають нові питання: а чи здатен інтелект не просто довести теорему, а сформулювати таку теорему як це роблять математики? Кожна така новина подається так, наче ми на крок ближче до моменту, коли машина стане по-справжньому розумною. Але чи це справді так? І що взагалі означає "розумна машина"?
Чому доведена теорема не доводить наявність розуму
Уявімо звичайну людину — не математика, не вченого, а, скажімо, продавця в магазині або водія таксі. Покажіть їй формулювання гіпотези Пуанкаре чи теореми Ферма. Швидше за все, вона не зрозуміє навіть умови задачі, не кажучи вже про хід доведення. Проте ніхто не сумнівається, що ця людина розумна: вона орієнтується в просторі, приймає рішення, розуміє контекст розмови, відчуває емоції, будує плани на майбутнє, а коли їй потрібно розв'язати якусь задачу знаходить відповідний математичний сервіс та отримує результат навіть не вміючи розв'язувати ті задачі.
Виходить дивна ситуація. Система, яка вміє доводити складні теореми, за формальною ознакою демонструє неабияку "компетентність". Але компетентність у вузькій галузі — це не те саме, що розум у загальному сенсі. Шаховий рушій обіграє будь-якого гросмейстера, проте ніхто не вважає його розумною істотою — це просто добре налаштований алгоритм пошуку варіантів.
Здатність розв'язувати конкретну задачу — це ознака навички. Здатність розуміти, чому ця задача важлива, чому саме такий підхід підходить, і застосовувати цей досвід у геть іншій сфері — ось що ближче до розуму.
Що таке інтелект — спроба визначення
Проблема в тому, що навіть серед науковців немає єдиного узгодженого визначення інтелекту. Психологи, філософи та фахівці з інформатики пропонують десятки формулювань, і кожне з них підкреслює свій аспект.
Основні складові, які зазвичай виділяють
Якщо узагальнити найпоширеніші підходи, можна виділити кілька ключових ознак, які частіше за все асоціюють із наявністю інтелекту:
- здатність переносити знання з однієї галузі в іншу, а не лише виконувати вузьку задачу, для якої система спеціально навчена;
- розуміння причинно-наслідкових зв'язків, а не просто статистичних кореляцій у великому масиві даних;
- уміння формулювати нові цілі самостійно, а не діяти лише в межах заданого завдання;
- здатність адаптуватися до принципово нової, раніше не відомої ситуації без додаткового перенавчання;
- наявність внутрішньої моделі світу, яку система може використовувати для прогнозування наслідків своїх дій.
Якщо приміряти цей список до сучасних мовних моделей та спеціалізованих систем для доведення теорем, картина стає значно скромнішою. Так, модель може блискуче впоратися з конкретною математичною задачею. Але як діятиме у не стандартній ситуації коли взагалі не знайди ніяких аналогій?
Що таке "вузький" і "загальний" штучний інтелект
Вузький ШІ (Narrow AI) — це система, налаштована на виконання однієї конкретної задачі чи класу задач, наприклад розпізнавання зображень або доведення теорем певного типу. Поза межами цієї задачі така система не має жодних переваг перед звичайним алгоритмом. Загальний штучний інтелект (AGI, Artificial General Intelligence) — це гіпотетична система, яка здатна розуміти, навчатися та застосовувати знання в будь-якій інтелектуальній задачі так само гнучко, як людина. Наразі всі відомі досягнення ШІ, включно з доведенням теорем, належать саме до категорії вузького інтелекту.
Чи достатньо старого тесту Тьюринга
Класичний тест Тьюринга, запропонований у 1950 році, передбачає просту ідею: якщо людина під час текстового спілкування не може відрізнити машину від людини, то машину можна вважати такою, що мислить. Довгий час цей тест вважався золотим стандартом. Але сучасні мовні моделі вже здатні досить переконливо імітувати людське спілкування у короткому діалозі, і це аж ніяк не означає, що вони мислять у повному сенсі слова.
Проблема в тому, що тест Тьюринга перевіряє здатність до імітації, а не до розуміння. Модель може підбирати правдоподібні відповіді на основі величезного масиву текстів, не маючи жодного уявлення про те, що ці слова насправді означають. Філософ Джон Серл ще у 1980 році описав це у знаменитому уявному експерименті "Китайська кімната": людина всередині кімнати може механічно перекладати ієрогліфи за інструкцією, не розуміючи китайської мови взагалі, і зовнішньому спостерігачу здаватиметься, що кімната "розуміє" мову.
Які альтернативи пропонують сьогодні
Через обмеженість класичного тесту Тьюринга дослідники пропонують нові підходи до оцінки машинного інтелекту:
- Тест на перенесення знань — здатність системи застосувати навичку, отриману в одній галузі, для розв'язання зовсім іншої задачі без додаткового навчання.
- Тест на створення нових задач — здатність системи самостійно поставити собі мету, а не лише виконувати вказівки людини.
- Тест на розуміння причинності — здатність відрізняти справжню причину події від простого статистичного збігу.
- Тест на адаптацію в реальному часі — здатність діяти у фізичному або віртуальному середовищі, яке постійно змінюється непередбачувано.
- Тест ARC (Abstraction and Reasoning Corpus), розроблений дослідником Франсуа Шолле, який перевіряє здатність розв'язувати абстрактні візуальні головоломки, що вимагають узагальнення, а не запам'ятовування шаблонів.
Цікаво, що саме останній тест, ARC, вважається одним із найскладніших орієнтирів для сучасних систем. На відміну від математичних олімпіадних задач, де можна натренувати модель на тисячах подібних прикладів, задачі ARC щоразу вимагають новий, унікальний спосіб мислення — саме те, що людина робить інтуїтивно, а машина поки що з великими труднощами.
Чому питання залишається відкритим
Мабуть, чесна відповідь звучить так: ми поки не маємо єдиного, беззаперечного критерію, який точно скаже "ось тепер це розум". Кожна нова новина про черговий рекорд ШІ — це радше сходинка, ще один доказ того, що система стає потужнішою у вузькій галузі, ніж підтвердження появи загального інтелекту. І доки моделі не почнуть самостійно ставити собі запитання, формулювати нові цілі та переносити досвід між абсолютно різними сферами так само легко, як це робить звичайна дитина, розмова про "справжній" штучний розум залишатиметься радше філософською, ніж технічною.
Можливо, річ навіть не в тому, щоб знайти ідеальний тест. Можливо, сама ідея єдиного критерію — це пастка, і розум варто вимірювати не одним показником, а цілим набором ознак одночасно, як це роблять із людським інтелектом психологи. А яка ознака здається вам найважливішою — розуміння причинності, здатність ставити власні цілі, чи щось інше? Поділіться своєю думкою в коментарях — цікаво дізнатися, з якого боку ви дивитеся на це питання.
Схожі публікації
